KI-KompassAusgabe 22 · KW 46
Modelle
Zwei neue Spitzenmodelle. Beide Anbieter empfehlen dir ein anderes.
Claude Fable 5.2 und Gemini 4 Carbon sind da. Warum die Rangliste weniger zählt als eine Abbruchregel, zeigt ein KI-Agent bei Fiege.
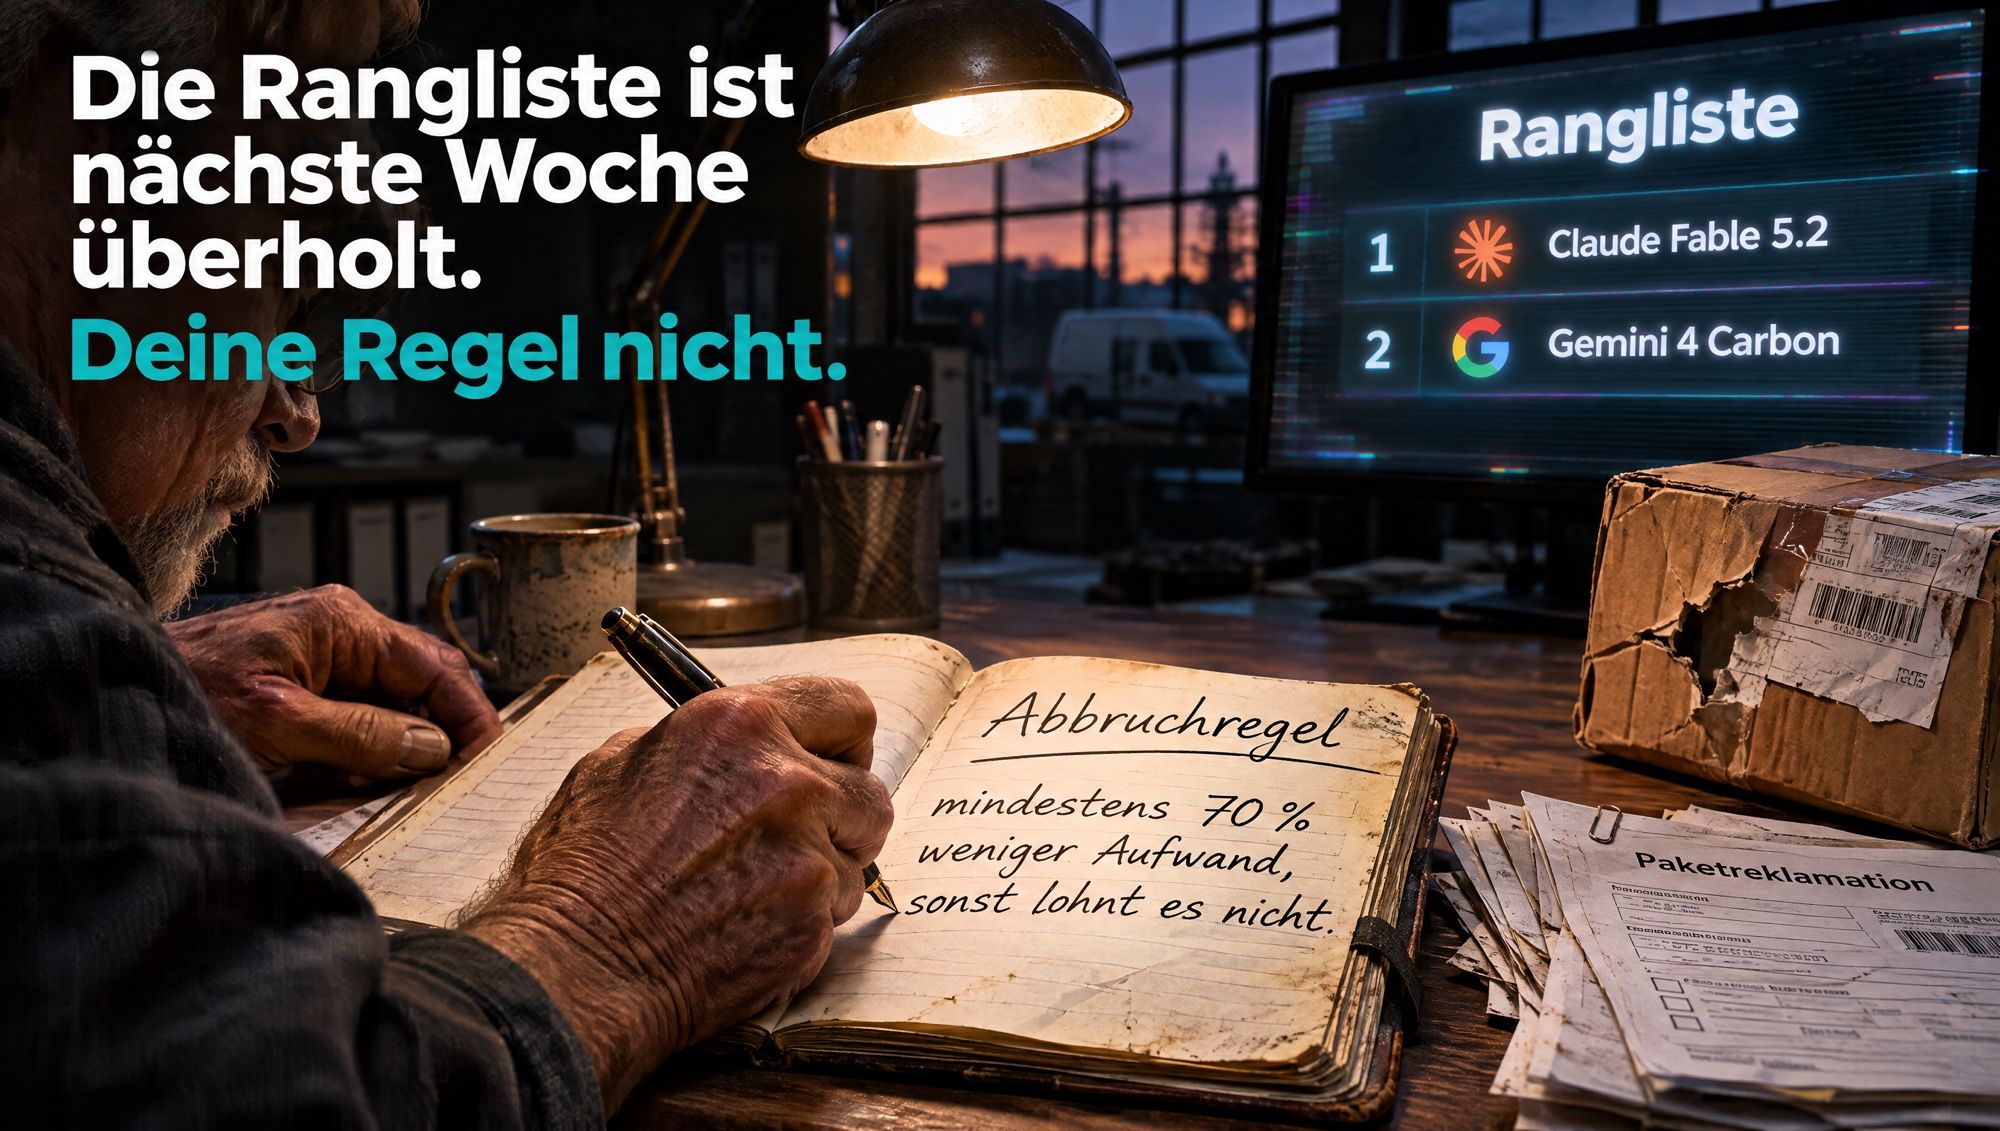
Am 9. November hat Anthropic Claude Fable 5.2 vorgestellt, einen Tag später hat Google Gemini 4 Carbon für alle zahlenden Entwickler und Firmen freigeschaltet. Beide sind die stärksten Modelle ihres Hauses. Google hatte Carbon bei der Vorstellung am 28. Oktober Platz 1 in der unabhängigen Rangliste von Artificial Analysis zugeschrieben. Stand 12. November liegt dort Fable 5.2 vorn.
Interessanter sind die Sätze, die in beiden Ankündigungen weiter unten stehen. Anthropic empfiehlt, für die meisten Aufgaben beim Programmieren und in der Wissensarbeit mit dem Alltagsmodell Opus 5.5 zu starten. Google schreibt, Gemini 4 Argon bleibe „die ideale Wahl“ für den Großteil solcher Arbeit. Die Spitzenmodelle sind für Aufgaben gedacht, die an die Grenzen eines Modells gehen.
Das Modell war bei Fiege die kleinste Frage
Wie wenig die Rangliste über den Nutzen sagt, zeigt ein Fall aus der Logistik. Der Dienstleister Fiege reklamiert für Onlinehändler verlorene und beschädigte Pakete bei den Paketdiensten, mehr als zehntausend Fälle im Monat bei über 50 Paketdiensten. Zeitweise haben 14 Leute nichts anderes gemacht, ein Fall dauerte 15 bis 25 Minuten. Seit Herbst 2024 erledigt das ein KI-Agent, ein Programm, das die Fälle selbstständig bearbeitet. t3n hat den Fall diese Woche noch einmal beschrieben.
Welches Modell darin steckt, steht nicht im Artikel. Dort steht, was entschieden hat. Vor der ersten Zeile Code legte Fiege eine Abbruchregel fest: mindestens 70 Prozent weniger Aufwand, sonst lohnt es nicht. Der erfahrenste Sachbearbeiter wechselte ins Projekt und schrieb sein Wissen als Regeln für den Agenten auf. Und der Agent antwortet nur selbst, wenn er sich sicher genug ist, sonst bekommt ein Mensch den Fall. Nach neun Monaten Entwicklung war das Ziel erreicht.
Für deinen Betrieb heißt das: Die Frage, welches Modell gerade das beste ist, kannst du dir meistens sparen. Die Antwort ist in einer Woche überholt, und für die meisten Aufgaben raten die Anbieter selbst zum Alltagsmodell. Entscheidend ist, ob du weißt, was die Lösung leisten muss, und wer in deinem Betrieb die Regeln kennt.
Was du jetzt tun kannst
- Nimm im Alltag das Modell, das dein Anbieter selbst dafür empfiehlt, und wechsle nur für Aufgaben, an denen es nachweislich scheitert.
- Schreib vor dem nächsten KI-Projekt eine Abbruchregel auf: Wie viel Aufwand muss es sparen, damit es sich lohnt?
- Hol den Menschen ins Projekt, der die Fälle heute am besten kennt, und lass ihn die Regeln aufschreiben.
Quellen
- Introducing Claude Fable 5.2 and Claude Mythos 5.2 (Anthropic)anthropic.com
- Gemini 4 Carbon is now available (Google)blog.google
- Gemini 4 Carbon: our next frontier model (Google, 28.10.2026)blog.google
- Rangliste der Sprachmodelle (Artificial Analysis)artificialanalysis.ai
- Fiege: KI-Agent automatisiert 70 Prozent der Carrier Claims (t3n)t3n.de
- FIEGE: Automated Carrier Claims Management Using AI Agents (ZenML)zenml.io